
類CLIP(Contrastive Language-Image Pretraining)的視覺-語言模型在視訊檢索、影像生成等各種任務中變得越來越重要,理解這些模型複雜的內部運作過程對於負責任和安全的AI部署至關重要。
為了深入了解類CLIP基礎模型的複雜運作,英特爾實驗室推出CLIP-InterpreT工具,協助使用者以結構化且容易理解的方式探索這些模型的內部機制。
該工具不僅限於簡單的輸入輸出觀察,而是透過分析個別的注意力頭(Attention Heads),揭露模型的不同部分如何助力視覺和文字理解,包括屬性識別與影像分割。
CLIP-InterpreT提供五種類型的分析,包括:以屬性為基礎的最近鄰搜尋(Nearest Neighbors Search)、每個注意力頭的主題分割、對比分割,以及針對影像和文字的每個注意力頭最近鄰搜尋。
除此之外,CLIP-InterpreT透過強化模型的透明度和可解釋性,讓研究人員與開發者能除錯、精煉,以及建立對強大AI系統的信任,確保在像是自動駕駛導航等應用中,更安全、可靠地整合AI。
儘管CLIP模型廣受歡迎,但其複雜的架構和龐大的資料集使其常被視為「黑盒子」,缺乏透明度產生另一挑戰:若無法理解模型做出特定預測的原因,便難以確保其可靠性、公平性以及符合道德。
這個問題在像是自動駕駛系統或是內容審核等高風險應用中特別重要,因為其模型的決策必須可解釋。
全方位的可解釋性分析套件
CLIP-InterpreT的可解釋性分析揭露了CLIP內部機制的運作方式。可以觀察模型的哪些部分專門處理特定屬性、如何根據文字提示對影像進行分割,以及如何建立視覺與文字表達之間的聯繫。
這些見解可用於除錯,並透過識別類CLIP模型的偏見與弱點來改善模型。藉由理解模型的決策過程及其運作方式,可以開發更可靠並值得信賴的AI應用。
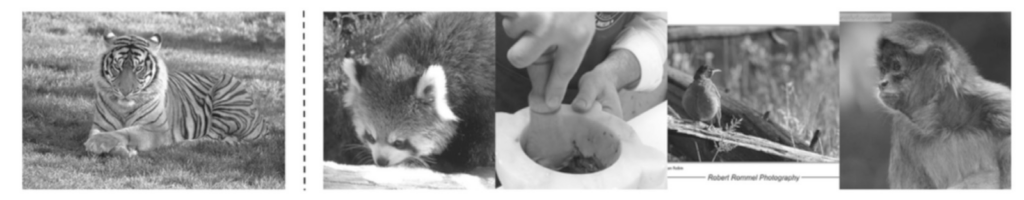
CLIP-InterpreT運用五種可解釋性分析方法,幫助使用者解析類CLIP模型的內部運作過程:
1. 基於屬性的最近鄰搜尋
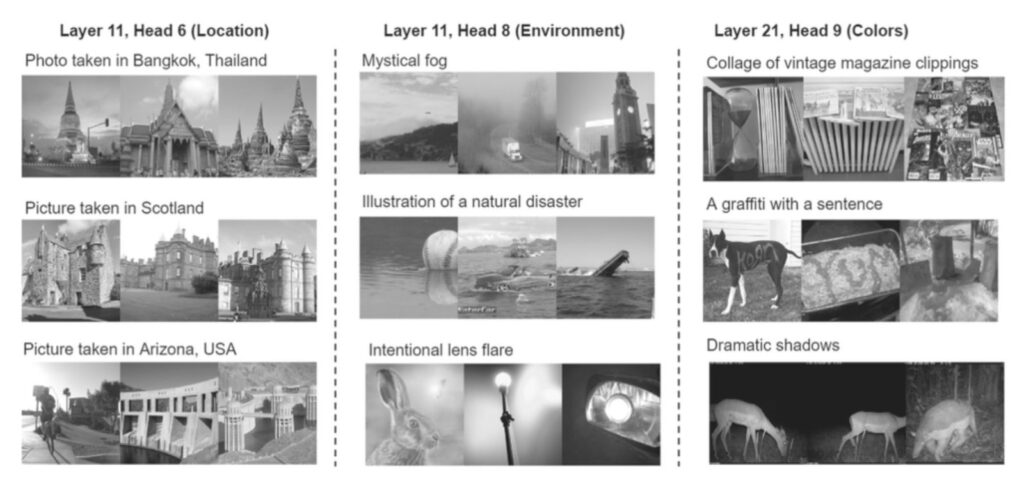
此分析方法透過根據特定屬性(例如顏色、位置或動物)在ImageNet中尋找類似的影像,來識別模型中專注於特定屬性的層級和注意力頭。CLIP-InterpreT利用OpenAI的ChatGPT進行情境標註,識別跨層級和注意力頭重複出現的屬性,有助於特徵化不同模型片段,如圖1所示。
2. 逐頭主題(Per-head Topic)分割
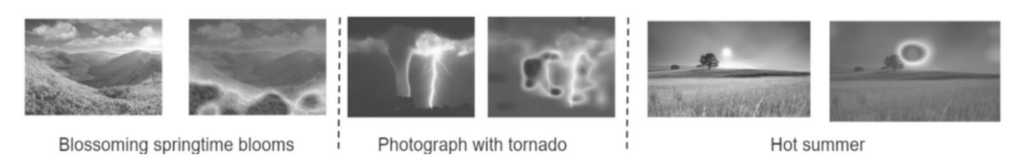
透過將既定的文字輸入映射到投影在影像上的分割圖,這種技術展示了特定注意力頭如何與文字定義的概念相關聯,揭露了不同注意力頭如何對影像中的元素進行優先排序,如圖2所示。
3. 對比分割
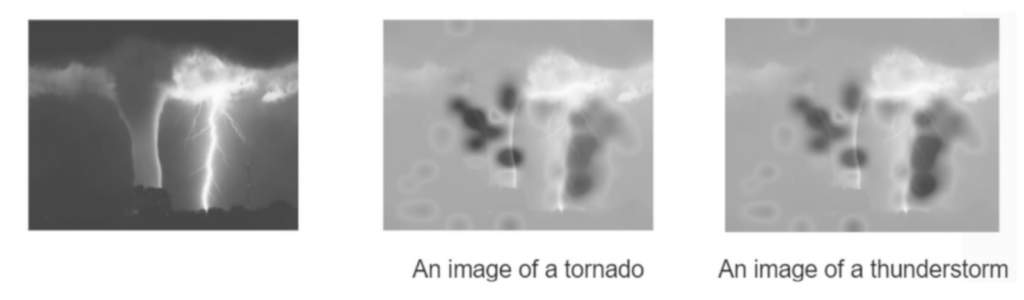
在此分析中,模型對比兩組文字輸入,觀察它們如何影響對影像的視覺解讀。這讓使用者能夠了解模型如何從視覺上區分不同概念,突顯模型對文字提示的細微理解如圖3所示,其展現了ViT-L-14模型(LAION-2B資料集)對「龍捲風」和「雷暴」的對比分割結果。
4. 逐頭影像的近鄰
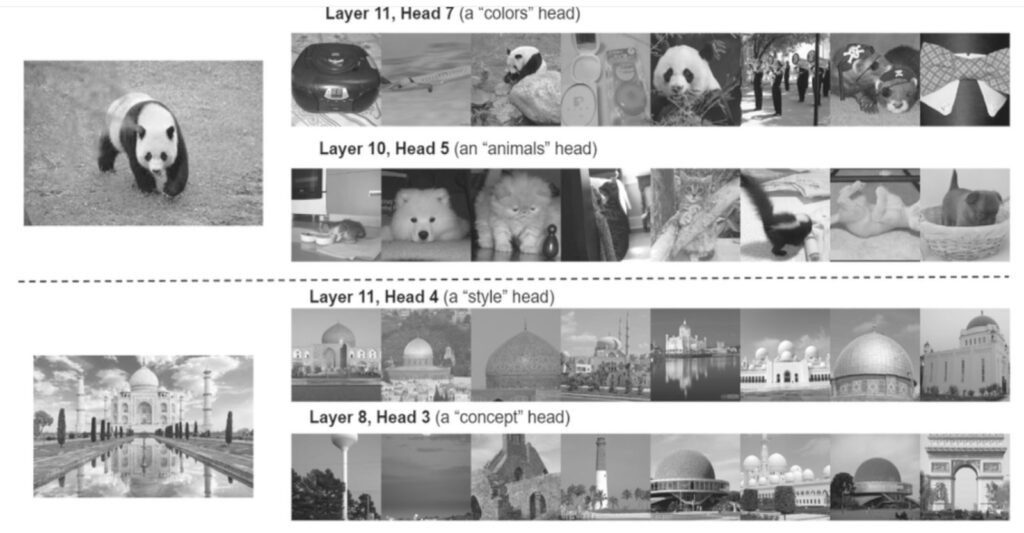
這種分析方式是利用注意力頭的中間表示(Intermediate Representations),根據特定屬性(例如顏色或物體相似性)尋找與既定輸入影像相似的影像,這有助於說明模型對特定視覺特徵的關注程度(圖4)。
此分析利用不同的注意力頭,為文字提示尋找最相關的影像。這透露了模型將文字描述與視覺範例進行匹配的能力,反映出模型在視覺空間中對語言的表述(圖5)。
從除錯到建立信任
CLIP-InterpreT讓視覺語言模型變得更透明,讓我們能夠更深入地了解這些模型的運作原理,並建立起對它們的信任。
使用CLIP-InterpreT之後,就能夠讓我們能深入了解視覺語言模型的運作機制,進而強化對AI的信任,並促進AI技術的發展。英特爾致力於打造透明、可解釋且公平的AI系統,CLIP-InterpreT正是實現這一目標的重要一步,它為視覺語言模型提供了更深入的解釋能力,促進了負責任的視覺-語言模型開發與部署。